


FP16、BF16、FP8、矩阵乘法效能翻倍
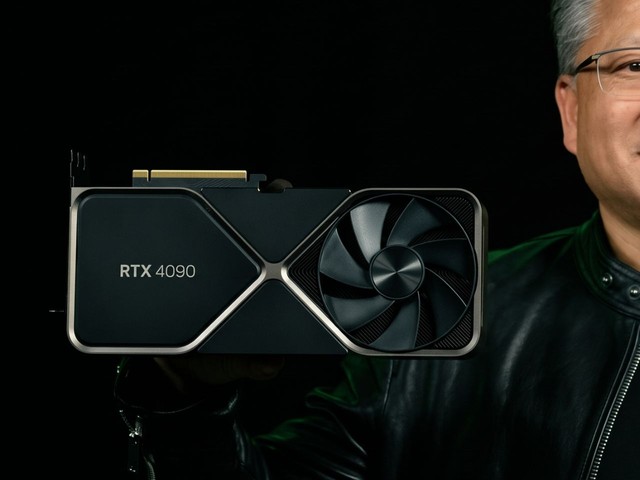
【RTX 40 宣告失守 😱】老黄,这就是你想要的 AI 世界了吗?昨日才说 RTX 40 没被破,相隔不到 12 小时就被另一位神人 JustAResearch 透过 AI 逆向工程攻破,成功解锁 GeForce RTX 40 系列的算力限制,涵盖 RTX 4090 至 RTX 4060 Ti 全系列产品。在无需刷写 vBIOS 及修改驱动程式的前提下,实现了 FP16、BF16、FP8 运算甚至矩阵乘法效能最高超过 2 倍的显着增长。
NVIDIA 为了利润最大化,往往会将半精度浮点算力与 vGPU 功能保留给昂贵的 Quadro、Tesla 及 A 系列等资料中心或工作站级专业显示卡。一般市售的 GeForce 游戏显示卡即使具备相同晶片核心,但效能与功能都被原厂在软体层面锁定。
根据 GitHub 开源专案「GPU-Unlock-Ada」作者表示,与前代 RTX 30 系列不同,RTX 40 系列导入了全新签名引导韧体(Signed Boot Firmware),并额外增设四道严密的权限验证关卡,导致先前的破解模组无法直接套用。
JustAResearch 指出,RTX 40 系列全线共用同一套底层引导韧体架构。新释出的载荷能够在作业系统驱动程式绑定显示卡硬体前,一次性绕过这四重权限验证。由于架构具备共用特性,只要针对 AD10x 核心的底层逻辑进行调整,便能同步通用于从旗舰级 RTX 4090 到主流级 RTX 4060 Ti 的完整产品线。
经多款显示卡实测验证,解除限制后的各款 Ada Lovelace 核心在深度学习与张量运算(Tensor Core)负载中展现出庞大的效能释放,AI 矩阵运算效能最高提升 2.14 倍。
◾GeForce RTX 4090:在 FP16 / BF16 指令吞吐量方面,直接从原本的 165.6 TFLOPS 翻倍攀升至 331.6 TFLOPS。在 500W 功耗设定下执行 cuBLAS $8192^3$ 矩阵乘法运算时,TF32 算力从 77.5 TFLOPS 暴增至 165.9 TFLOPS(达 2.14 倍),目前已在至少三张不同品牌的非公版显示卡上成功重现。
◾GeForce RTX 4080 SUPER:于 PyTorch 矩阵乘法环境测试下,FP16 运算自 110.6 TFLOPS 提升至 202.7 TFLOPS(提升 1.83 倍)。透过 mmapeak 实际量测,RTX 40 系特有的 FP8(FP32 累加)效能亦由 201.8 TFLOPS 跃升至 376.1 TFLOPS。
◾GeForce RTX 4070 Ti SUPER:在限制于 240W 功耗的情境下,FP16 / BF16 运算量由 95 TFLOPS 提高至 189.9 TFLOPS;而在 CUTLASS 4.8.1 原生 FP8 快速累加矩阵乘法测试中,更从 158.5 TFLOPS 提升到 309.1 TFLOPS(提升 1.95 倍)。验证结果显示,全数 322 万个输出单元皆维持「零位元误差(Zero-bit difference)」,确保了运算精确度完全未受损害。
◾GeForce RTX 4060 Ti 16GB:在三卡同机的对照测试中,即便受到 182W 功耗上限限制,BF16 与 FP16 效能依旧录得 38% 至 39% 的稳定增幅。
更重要的是,这次专案不仅在 Linux 能用,只要配搭 Hugging Face 平台上架的专属解锁工具(储存库名称为 TOTORONG/AD103_win_unlocker),就可在 Windows 平台使用。
资料来源:
