


是的,HKEPC 没有 RTX 5090 FE !! NVIDIA 正式发佈 GeForce RTX 5090 / 5090 D 显示卡,採用全新 GB202 绘图核心、升级新一代 Blackwell GPU 微架构,增至 21,760 CUDA Core、第 4 代 RT Core、第 5 代 Tensor Core 及 32GB GDDR7 记忆体。全新的神经渲染架构与 RTX 神经着色器开启了生成式 AI 游戏渲染新世代,加上 DLSS 4 的多帧生成功能令 FPS 帧率大幅提升。HKEPC 编辑部收到 NVIDIA 送测 RTX 5090 D 新卡,并与上代 RTX 4090 FE 进行对比测试。
经改良的 Blackwell SM 单元
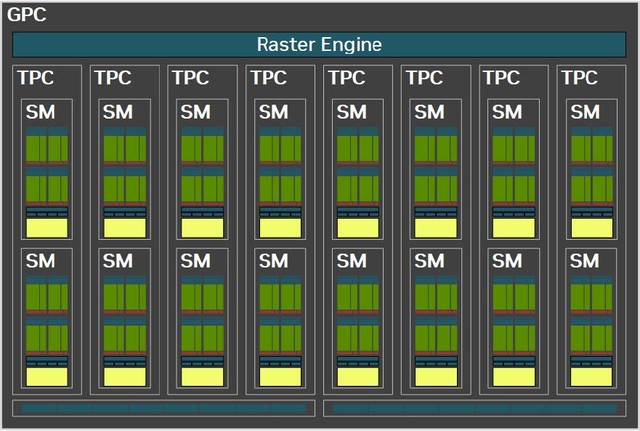
▲ Blackwell GPU 的 GPC 框架设计
GPC 是 NVIDIA GPU 中最顶层的硬体块,所有关键图形处理单元都位于 GPC 中。 Blackwell GPU 每个 GPC 包括 1 个专用的光栅引擎、 2 个光栅操作 (ROP) 分区,每个分区包含 8 个单独的 ROP 单元和 8 个 TPC,每个 TPC 包括 1 个 PolyMorph 引擎和 2 个 SM 单元。
完整的 GB202 GPU 拥有 128 MB 的 L2 快取,而 RTX 5090 则有 96 MB 的 L2,所有应用程式都受益于如此大的快速缓存记忆体池,并且光线追踪 (尤其是路径追踪) 等复杂操作将产生巨大的好处。
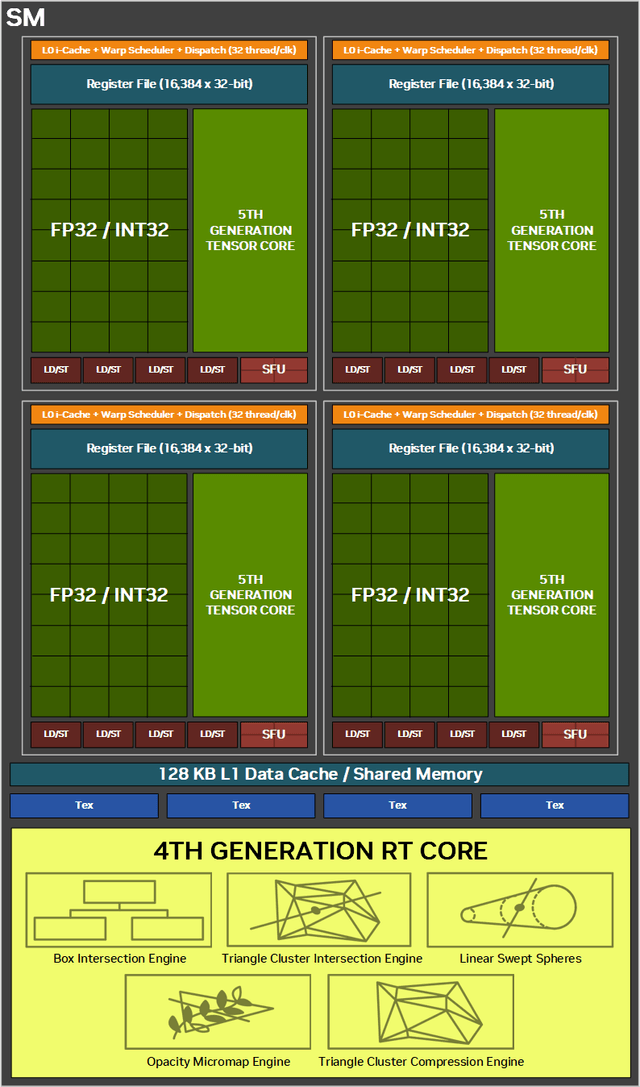
NVIDIA 串流多处理器 (SM) 是 NVIDIA GPU 架构的核心元件,在 GPU 的并行处理能力中发挥着关键作用,通过其各种内核(CUDA、Tensor、RT)实现大规模并行性、高效的 warp 调度、记忆体管理,并支援 AI 等现代工作负载。每个完整的 GB202 晶片包含 192 个 SM,每个 SM 包括 128 个 CUDA 核心、1 个 Blackwell 第四代 RT Core、4 个 Blackwell 第五代 Tensor Core、4 个 Texture Units、 1 个 256 KB 註册档和 128 KB 的 L1/共用记忆体,可以根据图形和计算工作负载的需求配置不同的记忆体大小。
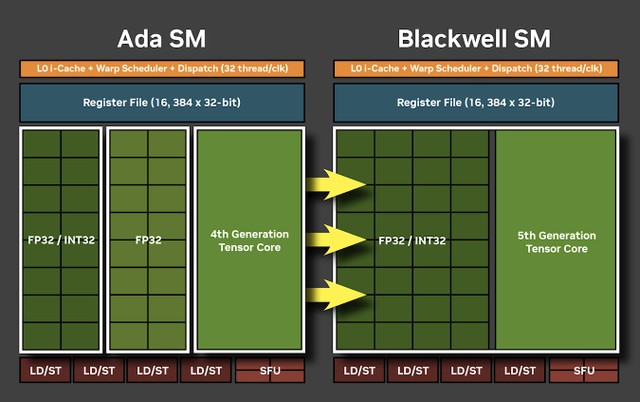
相较上代 Ada Lovelace 的 SM 设计,每个分区的 32 个 CUDA Core 当中 16 个是专门于处理 FP32 操作,另外 16 个可选择处理 FP32 或 INT32 操作,所以每个分区可提供 32 个 FP32 指令或 16 个 INT32 + 16 个 FP32 指令。新一代 Blackwell 的 SM 设计作出了更改,每个分区同样是 32 个 CUDA Core 但全部可以执行处理 FP32 或 INT32 操作,因此 Blackwell 的 INT32 整数运算数量与 Ada Loverlace 相比增加了一倍,由上代 41.3 TOPS 提升至 104.8 TOPS。
Texture Units 的数量也从 GeForce RTX 4090 的 512 个增加到 GeForce RTX 5090 的 680 个。Texture Units 的主要功能是处理纹理映射操作,包括提取纹素、应用纹理筛选以及处理座标。随着 Texture Units 的增加,Blackwell 在双线性过滤的纹素速率大幅提升,相比 GeForce RTX 4090 每秒 1290.2 Gigatexels/s 的性能,GeForce RTX 5090 提升至 1636.76 GT/s。
Blackwell 的 Texture Units 在每个週期的纹理採样性能相比 Ada Lovelace 提高了一倍,这主要得益于加速部份纹理访问的演算法改进,例如与 Blackwell 神经纹理压缩方法一同使用的随机纹理过滤(STF)。因此,GeForce RTX 5090 在 Texture 性能上实现了显着的提升。
升级至 Blackwell 第 5 代 Tensor Cores
Tensor Core 是 NVIDIA GPU 专用的高性能运算核心,专为满足 AI 和 HPC 应用程式中矩阵乘法和累加数学运算的需求而设计。它对深度学习神经网络的训练和推理操作至关重要。与 Ada Lovelace 架构的 Tensor Core 一样,Blackwell 的 Tensor Core 支援 FP16、BF16、TF32、INT8、INT4,以及 Hopper 的 FP8 Transformer 引擎。而 Blackwell 更进一步,新增了对 FP4 和 FP6 的 Tensor Core 操作支援,并引入了第二代 FP8 Transformer 引擎,其功能与数据中心级 Blackwell GPU 完全一致。
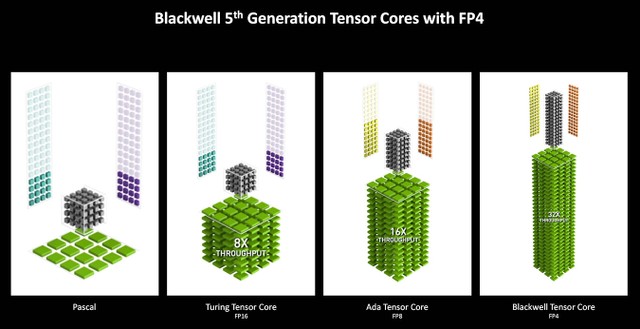
其中最值得关注的是对 FP4 格式的新增支援。随着 AI 模型参数和大小的逐渐增加,对 GPU 性能及记忆体容量的需求也在快速上升,即使是最新硬件也可能面临挑战。GeForce RTX 50 系列透过其全新 Tensor Core 引入了对 FP4 数据格式的支援。FP4 提供了一种更低的量化方法,类似于档案压缩,可显着缩小模型大小。
与 FP16 精度相比(大多数模型预设使用的精度方法),FP4 精度仅需要不到一半的记忆体空间。同时,GeForce RTX 50 系列 GPU 的性能是在上一代的两倍以上。当 AI 模型选择 FP4 格式,并使用 NVIDIA TensorRT Model Optimizer 提供的高级量化技术时,输出的作品几乎不会有品质下降。
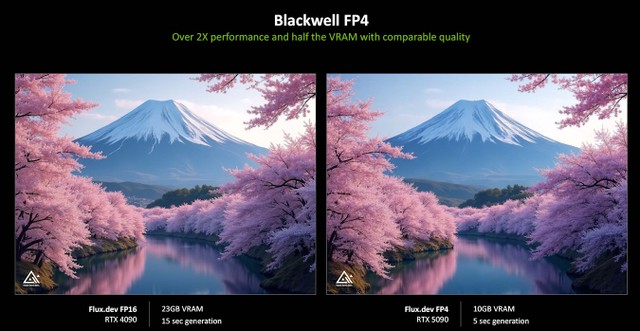
举例来说,Black Forest Labs 的 FLUX.dev 模型在使用 FP16 精度时需要超过 23GB 的 VRAM,这意味着只有 GeForce RTX 4090、RTX 5090 和专业级 GPU 才能支援。然而,在使用 FP4 格式后,FLUX.dev 需要的记忆体降至不到 10GB,这使得更多 GeForce RTX GPU 能够本地运行该模型。
在性能方面,使用 FP16 的 GeForce RTX 4090,FLUX.dev 模型可以在 15 秒内完成 30 个步骤生成图像。而使用 FP4 的 GeForce RTX 5090,只需约 5 秒即可完成相同的生成操作。
